
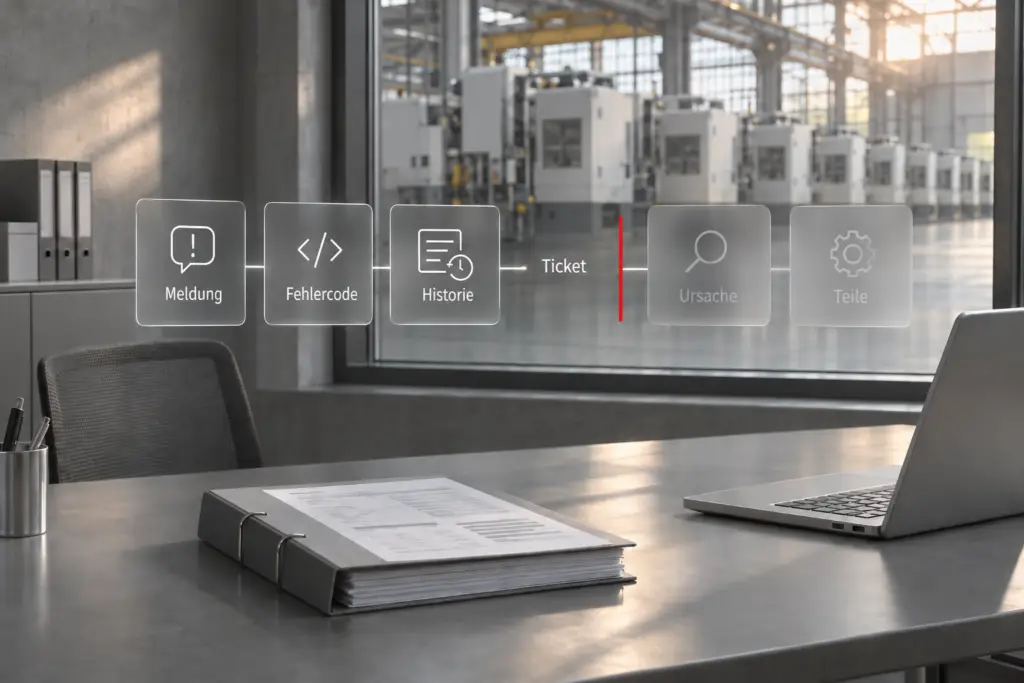
Drei Anbieter haben im Herbst ihre Service-KI vorgeführt, und alle drei haben überzeugt. Die KI erkennt den Fehler, nennt das passende Ersatzteil und zeigt die Stelle im Servicehandbuch. Im typischen Szenario hat der Hersteller rund 3.000 Maschinen im Feld, und im Januar wird das Budget für das nächste Jahr verteilt. Der Serviceleiter stellt die Frage, die keine Vorführung beantwortet: Wie oft hätte das System bei unseren eigenen Fällen richtig gelegen?
Diese Frage lässt sich beantworten, bevor Geld in ein Projekt fließt. Dafür reichen abgeschlossene Servicefälle, deren Ursache bekannt ist, und ein Test, der so gebaut ist, dass seine Zahl hält. Kurz vorab, worauf es ankommt:
- Abgeschlossene Fälle einer Baureihe als Testsatz. Zwölf bis 24 Monate, Ursache dokumentiert, und für jeden Anbieter derselbe Satz.
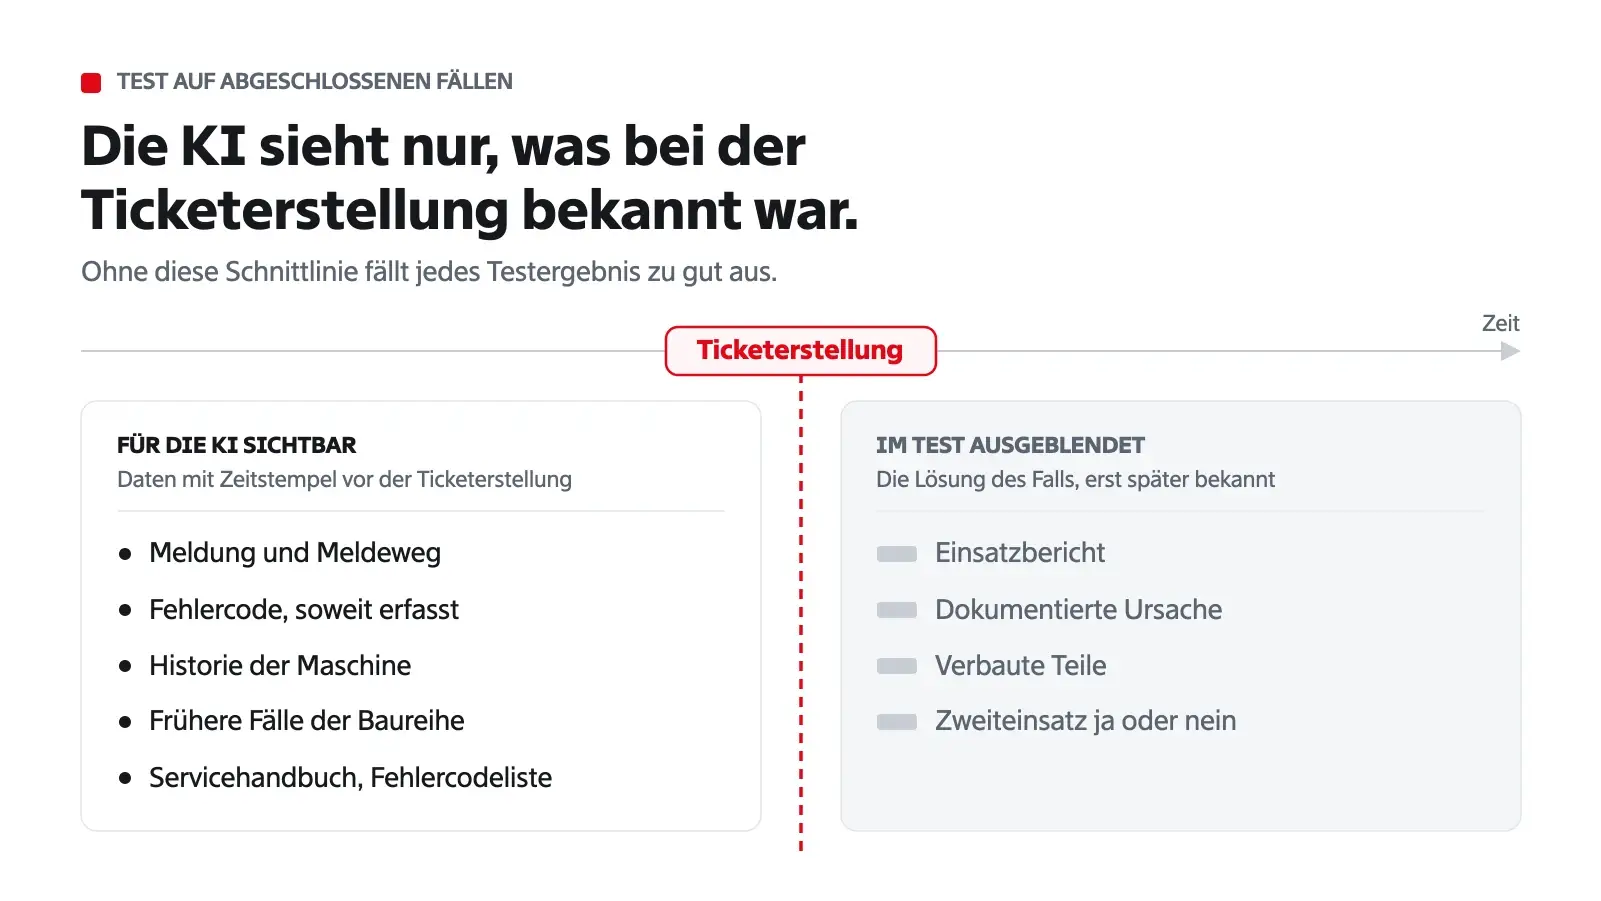
- Die KI sieht nur, was bei der Ticketerstellung bekannt war. Lösungsfelder und spätere Einträge bleiben verborgen, sonst fällt jedes Ergebnis zu gut aus.
- Fälle ohne dokumentierte Ursache werden gezählt und nicht bewertet. Ihr Anteil sagt viel über die eigene Falldokumentation.
- Ein Techniker aus dem eigenen Haus bewertet blind, und die Konfidenzwerte werden nachgezählt. Erst dann weiß man, ob man einem Wert von 80 Prozent trauen kann.
Sie wollen wissen, wie eine Service-KI auf Ihren abgeschlossenen Fällen abschneidet?
Im Backtest prüfen wir das an einem Maschinentyp, in drei bis vier Wochen und ohne Zugriff auf Ihre Produktivsysteme. Das Ergebnis darf auch lauten, dass es heute noch nicht passt.
→ Backtest auf der Produktseite SDI
Warum eine Vorführung wenig über Ihre Fälle sagt
Vorführungen laufen auf Fällen, die jemand ausgesucht hat. Die Meldung ist vollständig, die Seriennummer stimmt, der Fehlercode ist gepflegt, und zur Maschine gibt es eine saubere Historie. Unter diesen Bedingungen liefern heute viele Systeme gute Antworten.
Im Feld sieht ein Servicefall anders aus. Die Meldung kommt per Telefon, die Seriennummer fehlt, der Fehlercode steht im Freitext oder gar nicht. Die Ursache hat der Techniker irgendwann in den Einsatzbericht geschrieben, das getauschte Teil hängt am Arbeitsauftrag und nicht am Fall. Ob eine KI mit diesem Material zurechtkommt, zeigt keine Vorführung.
Das ist auch der Punkt, an dem viele Unternehmen zögern. In der aktuellen Bitkom-Erhebung nennen 40 Prozent der Unternehmen, die noch keine KI einsetzen, die schlechte Qualität der Ergebnisse als Hemmnis, bei den Unternehmen, die KI bereits nutzen, sind es 26 Prozent (Bitkom Research 2026, 603 befragte Unternehmen). Messen lässt sich diese Sorge nur auf den eigenen Daten. Eine Vorführung zeigt, was ein System kann, ein Test auf den eigenen Fällen zeigt, was es bei Ihnen kann.
Der Testsatz: eine Baureihe, abgeschlossene Fälle, ein Satz für alle
Ein aussagekräftiger Test beginnt mit der Auswahl. Am besten eignet sich eine Baureihe, von der viele Maschinen im Feld stehen und zu der im Innendienst regelmäßig Meldungen eingehen. Aus ihr nimmt man die abgeschlossenen Fälle der letzten zwölf bis 24 Monate, typischerweise 150 bis 300 Stück, mit einer Mischung aus einfachen Störungen und schwierigen Fällen, die mehrere Einsätze gebraucht haben.
Bei einer Flotte gleichartiger Maschinen trägt dieses Verfahren. Wer zwölf individuell gebaute Anlagen betreut, bekommt aus seinen Fällen keine belastbare Zahl, weil sich kaum ein Fall wiederholt.
Was in den Export gehört
Für jeden Fall wird gebraucht, was zum Zeitpunkt der Meldung bekannt war, und was danach herauskam:
- Betreff, Beschreibung, Meldeweg und Anlagedatum des Falls
- die Maschine mit Seriennummer, Baustand und Inbetriebnahme
- Fehlercode, soweit erfasst, und die Fallhistorie dieser Maschine vor der Meldung
- die dokumentierte Ursache, die Arbeitsaufträge mit den verbauten Teilen und die Information, ob ein Zweiteinsatz nötig war
- dazu für die Baureihe die Fehlercodeliste, das Servicehandbuch und die Wartungsunterlagen
Der Export reicht. Für den Test braucht niemand Zugriff auf das Produktivsystem, und Personendaten lassen sich beim Import pseudonymisieren.
Ein Testsatz für alle Anbieter
Wer mehrere Systeme vergleichen will, gibt allen denselben Satz, mit denselben Regeln für das, was die KI sehen darf, und mit derselben Bewertung. Bringt jeder Anbieter eigene Beispielfälle mit, vergleicht man am Ende vor allem die Auswahl der Fälle. Wie ein solcher Rückspiegel-Test im Rahmen eines Agentenpiloten abläuft, beschreibt unser Beitrag zum Agentforce-Pilot im Service. Hier geht es um die Frage, wann seine Zahl standhält.
Vier Fehler, die das Ergebnis schönen
Ein Test auf abgeschlossenen Fällen ist schnell aufgesetzt. Ebenso schnell liefert er eine Zahl, die zu gut ist. Vier Fehler sind dafür verantwortlich, und alle vier lassen sich im Bericht erkennen, wenn man weiß, wonach man sucht.
| Fehler | Woran Sie ihn im Bericht erkennen | Was dagegen hilft |
|---|---|---|
| Die KI sieht, was erst später bekannt war | Treffer auch bei Fällen, deren Meldung kaum Informationen enthielt | Je Fall nur Daten vor der Ticketerstellung, Lösungsfelder ausblenden |
| Fälle ohne dokumentierte Ursache verschwinden | Eine Trefferquote ohne Angabe, wie viele Fälle bewertet wurden | Diese Fälle zählen und ausweisen, aber nicht bewerten |
| Bewertet wird mit Kenntnis der KI-Antwort | Grenzfälle werden durchweg zugunsten der KI entschieden | Ein erfahrener Techniker bewertet eine Stichprobe blind |
| Konfidenzwerte ohne Nachprüfung | Fast jede Empfehlung trägt einen Wert um 80 oder 90 Prozent | Je Konfidenzbereich nachzählen, wie oft die Empfehlung stimmte |
Nur sehen lassen, was damals bekannt war
Ein Beispiel aus einem typischen Szenario: Ein Fall wurde mit „Temperatur wird nicht erreicht“ angelegt. Drei Tage später steht im Einsatzbericht „Heizpatrone getauscht“, am Arbeitsauftrag hängt das verbaute Teil. Bekommt die KI im Test den ganzen Fall zu sehen, findet sie die Antwort im Fall selbst und trifft. Über ihre Fähigkeit, eine Störung einzugrenzen, sagt das nichts.
Deshalb gilt für jeden Fall eine Schnittlinie: der Zeitpunkt der Ticketerstellung. Alles mit einem Zeitstempel davor darf die KI nutzen, also die Meldung, die Historie der Maschine, frühere Fälle derselben Baureihe und die Dokumentation. Alles danach bleibt verborgen. Ohne diese Regel ist jedes Ergebnis überhöht, und zwar umso mehr, je sorgfältiger die Techniker dokumentieren.
Fälle ohne Ursache zählen statt bewerten
In vielen Falldokumentationen steht am Ende „erledigt“, „Kunde meldet sich nicht mehr“ oder ein Freitext, aus dem keine Ursache hervorgeht. Solche Fälle lassen sich nicht bewerten, weil niemand weiß, was die richtige Antwort gewesen wäre. Werden sie still aussortiert, sieht die Trefferquote besser aus, als sie ist. Werden sie als Fehler gezählt, sieht sie schlechter aus.
Richtig ist, sie getrennt auszuweisen. Ihr Anteil ist selbst eine Kennzahl, und oft die aufschlussreichste des ganzen Tests: Sie zeigt, wie viel Wissen aus abgeschlossenen Fällen heute verloren geht, unabhängig davon, welches System später darauf arbeitet.
Blind bewerten und Konfidenzwerte nachzählen
Ob eine Ursachen-Hypothese fachlich trägt, erkennt ein erfahrener Techniker in Sekunden. Er sollte dafür aber nicht wissen, was die KI vorgeschlagen hat, und nicht, wie die automatische Bewertung ausgefallen ist. Eine Stichprobe von 40 bis 50 Fällen reicht. Ein guter Bericht weist dann auch aus, wie weit Techniker und automatische Bewertung auseinanderliegen.
Viele Systeme geben zu jeder Empfehlung einen Wert aus, etwa 82 Prozent. Dieser Wert beschreibt in der Regel, wie gut die Empfehlung durch Daten gestützt ist. Eine Trefferwahrscheinlichkeit ist er erst, wenn er nachgezählt wurde: Von hundert Empfehlungen mit einem Wert um 80 Prozent sollten ungefähr achtzig gestimmt haben. Diese Prüfung heißt Kalibrierung, und ein Test auf abgeschlossenen Fällen ist der einfachste Weg, sie zu machen.
Das gilt für jedes System, auch für unseres. Ein Konfidenzwert ist nur dann eine Entscheidungshilfe, wenn er Belege und Gegenbelege zeigt und wenn bekannt ist, wie oft er in der Vergangenheit gestimmt hat. Warum eine KI im Service dafür eine eigene Wissensbasis braucht, beschreibt der Beitrag KI im Service mit eigener Wissensbasis.
Was am Ende auf dem Tisch liegen sollte
Zwei Teile eines brauchbaren Berichts
Der erste Teil ist die Messung. Dazu gehören, jeweils bezogen auf die bewertbaren Fälle:
- wie oft die tatsächliche Ursache der erste Vorschlag war und wie oft sie unter den ersten drei lag
- wie oft das richtige Ersatzteil vorgeschlagen wurde
- welche Vor-Ort-Einsätze nach Einschätzung des Technikers vermeidbar gewesen wären
- welcher Anteil der Fälle oberhalb einer festgelegten Konfidenzschwelle liegt und wie gut die Werte kalibriert sind
- eine Hochrechnung mit Ihren eigenen Kostensätzen, mit offen ausgewiesenen Annahmen
Der zweite Teil ist die Bestandsaufnahme der Falldaten. Er zeigt, welche Lücken die Trefferquote begrenzen und in welcher Reihenfolge es sich lohnt, sie zu schließen: Ursachen, die nur im Freitext stehen, Teile ohne Bezug zum Fall, Fehlercodes, die nicht gepflegt werden, Wissen, das in Handbüchern oder bei einzelnen Technikern liegt und nie im System ankommt. Manche Lücke schließt ein Pflichtfeld im Abschlussdialog, manche braucht Nacharbeit am Bestand. Warum KI-Projekte im Service so oft genau hier hängen bleiben, beschreibt der Beitrag zur Datenreife im Service.
Dieser zweite Teil hat einen Wert, der über die Kaufentscheidung hinausgeht. Er gilt für jedes Werkzeug, das später auf den Servicedaten arbeiten soll. Und er macht sichtbar, was in der installierten Basis an Wissen steckt: Jeder sauber dokumentierte Fall verbessert die nächste Diagnose an einer baugleichen Maschine.
Drei mögliche Ausgänge
Ein ehrlicher Test kann auf drei Arten enden:
- Trefferquote und Datenlage tragen. Dann folgt ein Pilot auf dieser Baureihe, und die Werte aus dem Test sind die Ausgangsbasis, an der sich der Pilot messen lassen muss.
- Die Methode trägt, die Datenlage noch nicht. Dann kommen zuerst die Maßnahmen aus dem zweiten Berichtsteil, danach ein erneuter Test auf derselben Grundlage.
- Kein Fit zum jetzigen Zeitpunkt. Mit Begründung, und ohne Folgeprojekt.
Ein Test, der nur mit dem ersten Ausgang enden kann, ist eine Verkaufsveranstaltung. Fragen Sie deshalb jeden Anbieter vorab, wie er den dritten Fall berichtet.
Fazit: erst messen, dann budgetieren
Ob eine Service-KI bei Ihren Maschinen trägt, lässt sich vor der Budgetentscheidung klären. Gebraucht werden abgeschlossene Fälle einer Baureihe, eine klare Schnittlinie beim Zeitpunkt der Ticketerstellung, ein getrennter Ausweis der Fälle ohne Ursache, eine blinde Stichprobe und nachgezählte Konfidenzwerte. Mit diesen Regeln wird aus drei überzeugenden Vorführungen ein Vergleich, der auf Ihren eigenen Daten beruht.
logicline bietet diesen Test für Service Decision Intelligence (SDI) als Backtest an: ein Maschinentyp, drei bis vier Wochen, Festpreis, read-only. Jede Empfehlung kommt mit Belegen, Gegenbelegen und benannten Datenlücken, sodass im Bericht nachvollziehbar wird, warum eine Antwort stimmt oder nicht. Der Lauf findet in einem isolierten Tenant in der EU statt, Ihre Daten werden nach Abschluss gelöscht. Zwei Einstiege, je nach Ausgangslage:
- Backtest auf der Produktseite SDI – wenn Ihre Servicefälle im System dokumentiert sind und Sie vor der Budgetentscheidung eine gemessene Zahl wollen.
- Installed Base Assessment – wenn Maschinen, Fälle und Verträge heute über mehrere Systeme verteilt liegen und zuerst geklärt werden soll, welche Daten an der Maschine ankommen.
Fangen Sie bei der Baureihe an, zu der im Innendienst die meisten Meldungen eingehen. Dort ist die Fallzahl am größten und die Zahl am belastbarsten.
