
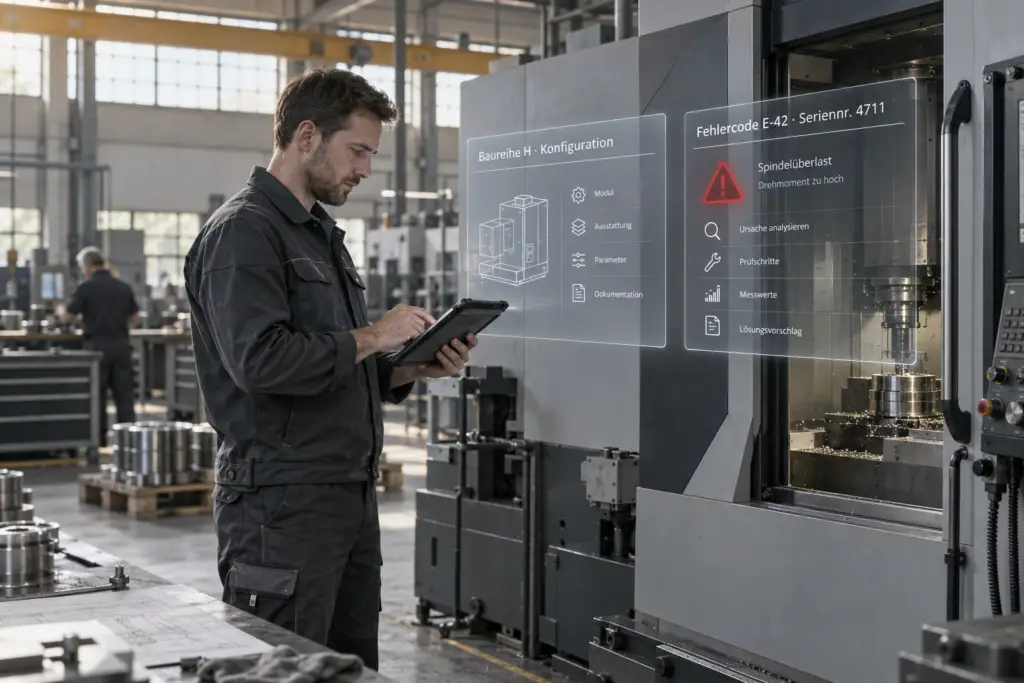
Ein Techniker steht vor einer stehenden Anlage, öffnet das Ticket zur Seriennummer 4711 und sucht in der Wissensdatenbank nach dem Fehlerbild. Er bekommt zweihundert Treffer zu „Vibration“ oder keinen einzigen zur konkreten Baureihe. In beiden Fällen ruft er am Ende den Kollegen an, der die Maschine kennt. Die Datenbank existiert, sie hilft nur nicht.
Der Engpass ist die Struktur, nicht die Zahl der Artikel. Eine Service-Knowledge-Base im Maschinenbau steht und fällt damit, ob Wissen am konkreten Asset hängt oder in einer flachen Themenliste liegt. Die Kurzfassung für Serviceleiter und Operations:
- Dasselbe Symptom hat je Baureihe eine andere Lösung. Eine Kategorienstruktur wie „Elektrik / Mechanik / Software“ führt den Techniker deshalb ins Leere.
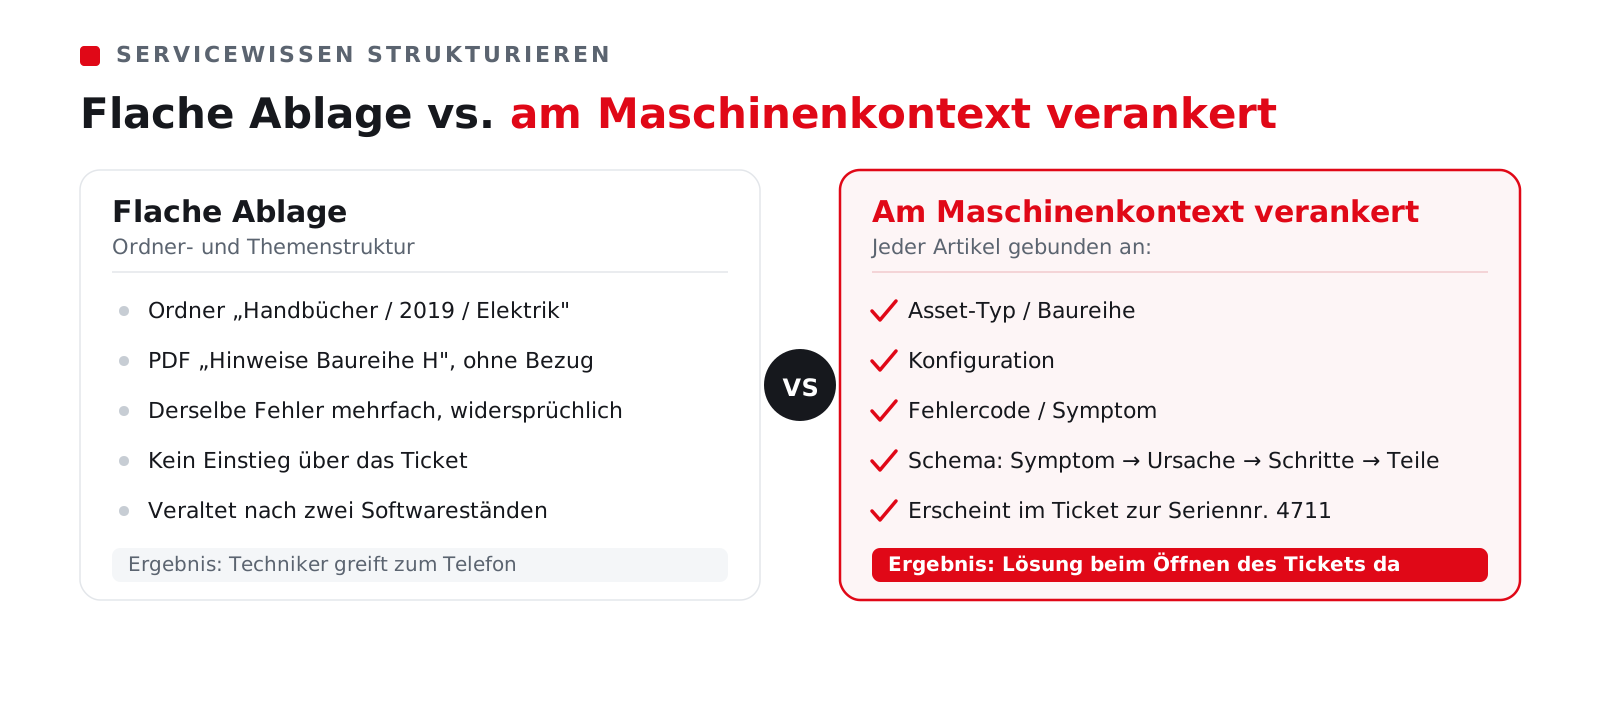
- Wissen wird am Maschinenkontext verankert. Asset-Typ, Konfiguration und Fehlercode sind die Achse, an der jeder Artikel hängt.
- Jeder Artikel folgt einem festen Schema. Symptom, geprüfte Ursache, Lösungsschritte, benötigte Ersatzteile – in dieser Reihenfolge, immer gleich.
- Voraussetzung ist eine strukturierte Maschinenakte. Ohne sie fehlt der Anker, an den sich der Artikel binden lässt.
Warum die meisten Wissensdatenbanken im Service verstauben
Die Ratgeber zum Aufbau einer Knowledge Base kommen fast alle aus dem IT-Support. Dort ist ein Problem in der Regel reproduzierbar: Ein Passwort-Reset läuft bei jedem Nutzer gleich. Im Maschinenservice gilt das nicht. Das gleiche Symptom, etwa ein Temperaturalarm an der Spindel, bedeutet bei der Baureihe von 2014 einen Sensordefekt und bei der überarbeiteten Version von 2019 ein Problem in der Kühlmittelführung. Wer beide Fälle unter „Spindel / Temperatur“ ablegt, produziert einen Artikel, der in der Hälfte der Einsätze in die Irre führt.
Dazu kommt die gewachsene Ablage. In vielen Serviceorganisationen liegt das Wissen in einer Ordnerstruktur nach dem Muster „Handbücher / 2019 / Elektrik“, ergänzt um PDFs auf einem Netzlaufwerk und Notizen in den Köpfen. Derselbe Fehler ist dort dreimal unterschiedlich beschrieben, zweimal veraltet. Der Techniker unter Zeitdruck sucht kurz, findet Widersprüchliches und greift zum Telefon. Die Basis war teuer im Aufbau und ist im Alltag totes Kapital.
Eine tragfähige Wissensbasis löst zwei Aufgaben zugleich: Sie muss den Artikel an die richtige Maschine binden, und sie muss ihn in ein Format bringen, das durch eine Entscheidung führt. Beides ist Strukturarbeit, keine Frage des Werkzeugs.
Ihre Wissensbasis wird nicht genutzt, obwohl Inhalte da sind?
In 30 Minuten schauen wir uns an einem konkreten Maschinentyp an, wie sich Ihre Serviceartikel am Asset verankern lassen und wo die Struktur heute bricht. Kein Folientermin, sondern ein Blick auf Ihre Ablage.
→ Erstgespräch vereinbaren
Wissen am Maschinenkontext verankern
Die tragende Entscheidung fällt vor dem ersten Artikel: Woran hängt das Wissen? Die Antwort ist der Maschinenkontext, und der besteht aus drei Ebenen.
- Asset-Typ / Baureihe – die Maschinengeneration, für die der Artikel gilt. Ein Fehlerbild der Baureihe H ist für die Nachfolgeserie oft falsch.
- Konfiguration – kundenspezifische Ausführung, verbaute Optionen, Softwarestand. Zwei Anlagen derselben Baureihe können sich hier unterscheiden.
- Fehlercode / Symptom – der konkrete Einstieg aus dem Servicefall, über den der Techniker den Artikel findet.
Diese Verknüpfung setzt voraus, dass die installierte Basis strukturiert vorliegt. Genau das leistet die Digitale Maschinenakte (IOTAM): ein Datensatz je Maschine mit Baureihe, Konfiguration, Umbauten, Softwareständen und Servicehistorie. Erst dieser Datensatz gibt dem Wissensartikel eine Adresse. Beim Öffnen des Tickets zu Seriennummer 4711 erscheinen dann die Artikel, die zu dieser Baureihe und dieser Konfiguration passen, und nicht der allgemeine Themenordner.
Das Schema eines Wissensartikels
Ist der Anker geklärt, folgt die zweite Strukturentscheidung: der innere Aufbau jedes Artikels. Freitext beschreibt, was ein Experte weiß, führt aber niemanden durch eine Diagnose. Ein Berufseinsteiger braucht eine feste Abfolge, und die ist bei jedem Artikel gleich.
| Baustein | Inhalt | Beispiel |
|---|---|---|
| Symptom / Fehlercode | Der beobachtbare Einstieg, so wie er im Ticket ankommt | Fehlercode E-42, Spindeltemperatur über Grenzwert |
| Geltungsbereich | Baureihe, Konfiguration, ggf. Softwarestand | Baureihe H, ab Softwarestand 3.2 |
| Geprüfte Ursache | Die bestätigte Ursache, nicht die Vermutung | Kühlmitteldurchsatz zu gering, Filter zugesetzt |
| Lösungsschritte | Nummerierte Prüf- und Handlungsschritte mit Ergebnis | 1. Durchfluss messen, 2. Filter prüfen, 3. tauschen |
| Ersatzteile | Konkrete Teilenummern für die Konfiguration | Filterpatrone Art.-Nr. 55-2071 |
Standardisierte Vorlagen für diese Bausteine sind der wirksamste Hebel für Konsistenz. Wenn jeder Artikel gleich aufgebaut ist, findet der Techniker die Lösungsschritte an derselben Stelle, unabhängig davon, wer den Artikel geschrieben hat.
Gut und schlecht im Vergleich
Ein schwacher Artikel trägt den Titel „Probleme mit der Spindel“ und besteht aus drei Absätzen Fließtext ohne Angabe der Baureihe. Er ist inhaltlich vielleicht richtig, im Einsatz aber wertlos, weil unklar bleibt, ob er zur vorliegenden Maschine passt, und weil der Leser die Handlungsschritte aus dem Text herauslesen muss.
Ein guter Artikel heißt „E-42 Spindeltemperatur, Baureihe H ab SW 3.2″, nennt die geprüfte Ursache in einem Satz und listet vier nummerierte Schritte mit den zugehörigen Teilenummern. Er ist kürzer als der schwache und im Einsatz sofort brauchbar. Die Regel dahinter lautet: lieber knapp und sofort verfügbar als vollständig und ungenutzt.
Metadaten und Pflege leicht halten
Damit die Verankerung funktioniert, braucht jeder Artikel wenige Pflichtangaben als Metadaten: Baureihe, Konfiguration, Fehlercode und den Bearbeitungsstand. Diese Felder entscheiden darüber, ob der Artikel im Ticket automatisch erscheint. Alles Weitere ist Kür.
Die zweite Bedingung ist Pflege ohne Reibung. Wissen, das außerhalb des Arbeitsprozesses gepflegt wird, verfällt. Bewährt hat sich ein leichter Freigabe-Weg: Ein Techniker legt den Artikel im Fall an, ein Wissenskoordinator mit Serviceerfahrung prüft und veröffentlicht. Der Koordinator schreibt nicht selbst alle Inhalte, sonst wird er zum Engpass. Sinnvoll ist außerdem eine Aktualisierungsquote als Zielgröße, damit veraltete Artikel auffallen, bevor ihnen ein Techniker folgt. Wie sich diese Wissenserfassung methodisch in den Serviceprozess einbetten lässt, haben wir im Beitrag zur Integration von Wissensmanagement in den Service beschrieben.
Womit die Basis läuft
Die Struktur ist die eigentliche Arbeit, die Werkzeuge sind ausgereift. Für eine spezialisierte Wissensbasis mit geführter Diagnose setzen wir auf Empolis Service Express. logicline hat die Salesforce-Integration von Empolis Service Express mitentwickelt: Wissensartikel und geführte Diagnoseflows erscheinen dabei gefiltert nach der konkreten Maschine direkt in der Service-Konsole, während der Mitarbeiter den Fall bearbeitet. Die hier beschriebenen Struktur-Prinzipien gelten unabhängig vom Werkzeug und lassen sich ebenso mit Salesforce Knowledge umsetzen; entscheidend bleibt die Verankerung am Maschinenkontext.
Ein Beat weiter reicht die Basis über die manuelle Suche hinaus. Über Service Decision Intelligence (SDI) wird der geprüfte Wissensbestand zusammen mit Maschinen-, Auftrags- und Sensordaten abrufbar, für den Innendienst am Telefon und für KI-Agenten in Salesforce. Jede Empfehlung kommt mit Quellennachweis auf den zugrunde liegenden Artikel, und SDI läuft in der Infrastruktur des Kunden. Ohne strukturierte Wissensbasis bleibt eine solche KI im Service Stückwerk, weil ihr die zitierfähige Grundlage fehlt.
Einordnung: strukturierte Wissensbasis gehört in die Stufe „Vernetzen“
Im Modell Digitalisieren → Vernetzen → Entscheiden → Automatisieren sitzt die Service-Knowledge-Base auf Stufe zwei. Stufe eins liefert die Voraussetzung, nämlich die strukturierte Maschinenakte als Anker. Auf Stufe zwei kommt das Wissen an diesem Anker mit Servicehistorie und Betriebsdaten zusammen. Damit ist die Grundlage für Stufe drei gelegt, auf der eine KI Entscheidungen nachvollziehbar stützt.
Zwei benachbarte Fragen behandeln eigene Beiträge: Die Methode dahinter, also KCS-Prinzipien und Messung, vertieft der Überblicksbeitrag zum Wissensmanagement im Service. Wie das personengebundene Erfahrungswissen überhaupt in die Basis kommt, behandelt der Beitrag zum Wissenstransfer vor dem Renteneintritt. Dieser Artikel bleibt bei der Struktur der Basis selbst.
Nächster Schritt
Bei einer Service-Knowledge-Base entscheidet die Struktur der Ablage über den Nutzen: Sie muss den Bezug zur konkreten Maschine kennen. Der erste Schritt ist deshalb ein ehrlicher Blick auf die Datenbasis.
Zwei pragmatische Einstiege:
- Installed Base Assessment – wenn die installierte Basis heute über ERP, Excel und Dateiablagen verteilt liegt. Ohne strukturierte Maschinenakte fehlt der Wissensbasis der Anker.
- Erstgespräch – wenn die Datenbasis steht und Sie konkret klären wollen, welche Taxonomie und welche Vorlagen zu Ihrem Maschinenpark passen und in welchem Servicebereich der Pilot startet.
In beiden Fällen gilt: Fangen Sie bei den Baureihen an, die die meisten Eskalationen erzeugen. Dort zahlt sich Struktur zuerst aus.
